训练:让参数逐渐学会任务
给模型数据,比较预测与训练目标,用损失衡量差距。神经网络通常通过反向传播计算梯度,再用梯度下降等方法调整参数;多次重复,学到可用于预测的规律。
沿着我的学习路径,认识 AI
从熟悉的智能能力出发,理解模型怎样运作,再走进技术的历史。
01 / 总体概念
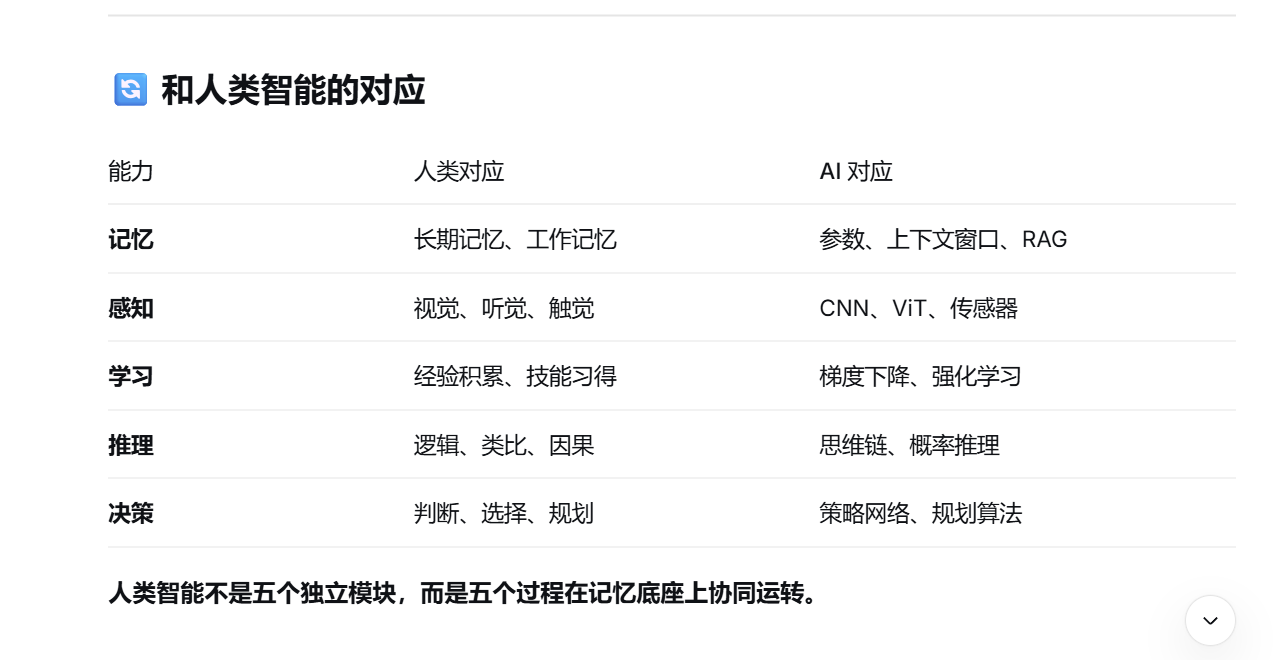
人工智能(AI)让计算机完成一些通常需要智能的任务:识别图像、理解语言、学习规律、进行推理,以及选择行动。我们可以从人熟悉的能力入手,理解它能帮我们做什么。
| 能力 | 生活中的理解 | AI 中的实现方式举例 |
|---|---|---|
| 记忆 | 记住所学知识,保留眼前的信息 | 模型参数保存学到的规律;上下文容纳当前信息;外部资料可通过检索(RAG)引入 |
| 感知 | 看见、听见,接收环境信号 | 把图像、声音或传感器数据转换为数字,再提取特征 |
| 学习 | 通过练习与反馈,积累经验 | 训练时调整模型参数;强化学习通过奖励反馈改进策略 |
| 推理 | 结合线索,逐步得出结论 | 生成中间步骤、进行概率推断,或使用符号规则 |
| 决策 | 比较选项,选择下一步行动 | 使用搜索、规划算法或策略模型选择行动 |
这是功能上的类比,方便我们入门。人类的这些能力会相互配合;AI 中的参数、上下文和外部资料也有各自不同的机制,不能与人脑中的记忆直接画等号。
一种方法是把规则、搜索和规划过程写进程序;另一种方法是让系统从数据和反馈中学习。现代神经网络属于后者:先设计计算结构,再用训练得到参数。
我们平时使用的 AI 工具,往往由模型 + 资料 + 工具调用组成。下面先从其中的“模型”讲起。
读图提示:这张表展示功能类比。思维链不保证推理正确;上下文和 RAG 也不意味着模型参数发生了学习。
进一步阅读:RAG:结合模型参数与外部检索资料
02 / 通用解释
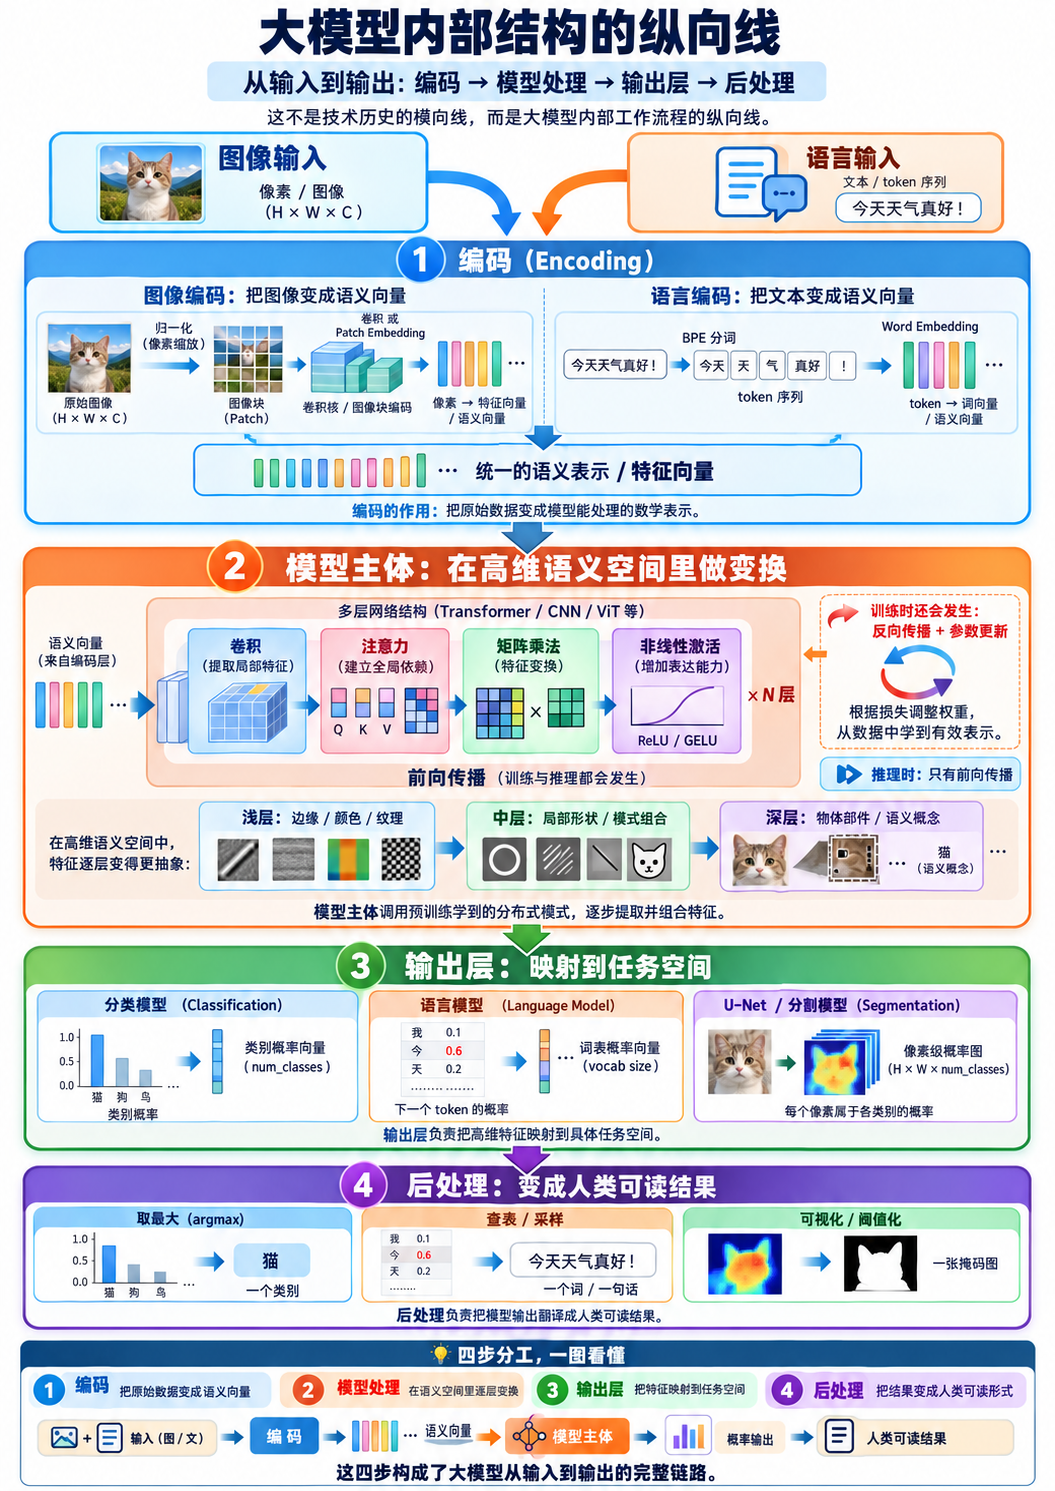
以神经网络为例:它接收数字形式的输入,按照计算结构和参数进行运算,再给出预测。结构规定“怎样算”,参数决定“具体算出什么”。
图片可以表示为像素数组或图像块;文字先分成 token,再映射到向量。
卷积或注意力等模块,结合矩阵运算、非线性变换和归一化,逐层处理特征。
例如,图像分类模型输出类别得分;语言模型输出下一个 token 的得分。
选择类别、采样 token,或将生成的表示解码成图像,供人阅读和使用。
这四步是理解流程的框架。输入编码和输出映射也可能属于模型本身;生成文字或图像通常需要反复调用模型,并结合采样等步骤。
给模型数据,比较预测与训练目标,用损失衡量差距。神经网络通常通过反向传播计算梯度,再用梯度下降等方法调整参数;多次重复,学到可用于预测的规律。
使用模型时,通常保持参数固定,执行前向计算。语言生成会逐个 token 重复这个过程;加入新的上下文或检索资料,并不等于更新了模型参数。
识别图片:猫的照片 → 提取特征 → 类别得分 → “猫”。
生成文字:当前上下文 → 下一个 token 的得分 → 选择一个 token → 加入上下文,继续生成。
生成图片:提示词和噪声 → 反复预测并更新 → 解码为图像。具体过程取决于模型与生成方法。
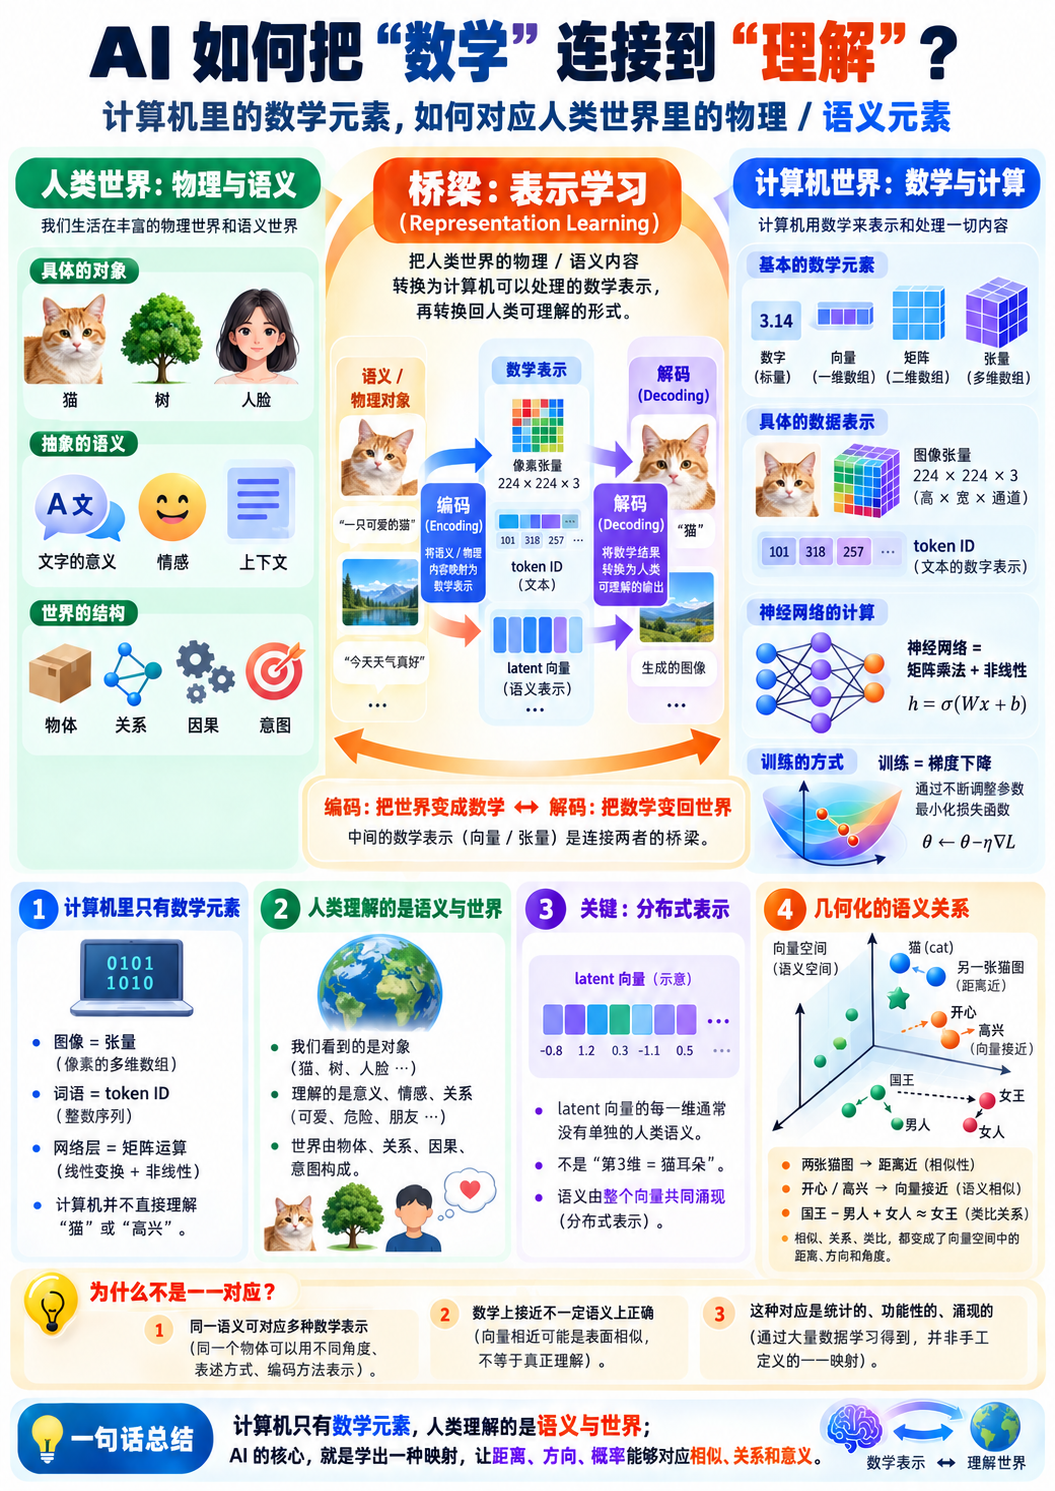
先读上面的通用解释,再按兴趣展开细节。原图保留学习过程,旁边的说明补充适用范围。
读图提示:token ID 是编号;模型学到的向量才承担特征表示。不同模型的表示空间不一定共享;向量接近也不保证语义理解正确。图中的类比算式是直观示意。
读图提示:这是一张概念总览,各种模型不会都按“卷积 → 注意力 → 矩阵乘法”排列。矩阵运算本身就在许多模块内部;不同任务也会使用不同的输入表示与输出方式。
读图提示:这是架构示例,归一化方式、偏置和参数比例会随模型变化。RoPE 通常在注意力中对 Q、K 应用位置相关旋转,并不是加到词向量上的一层位置嵌入。图中参数比例不能当作所有模型的固定比例。
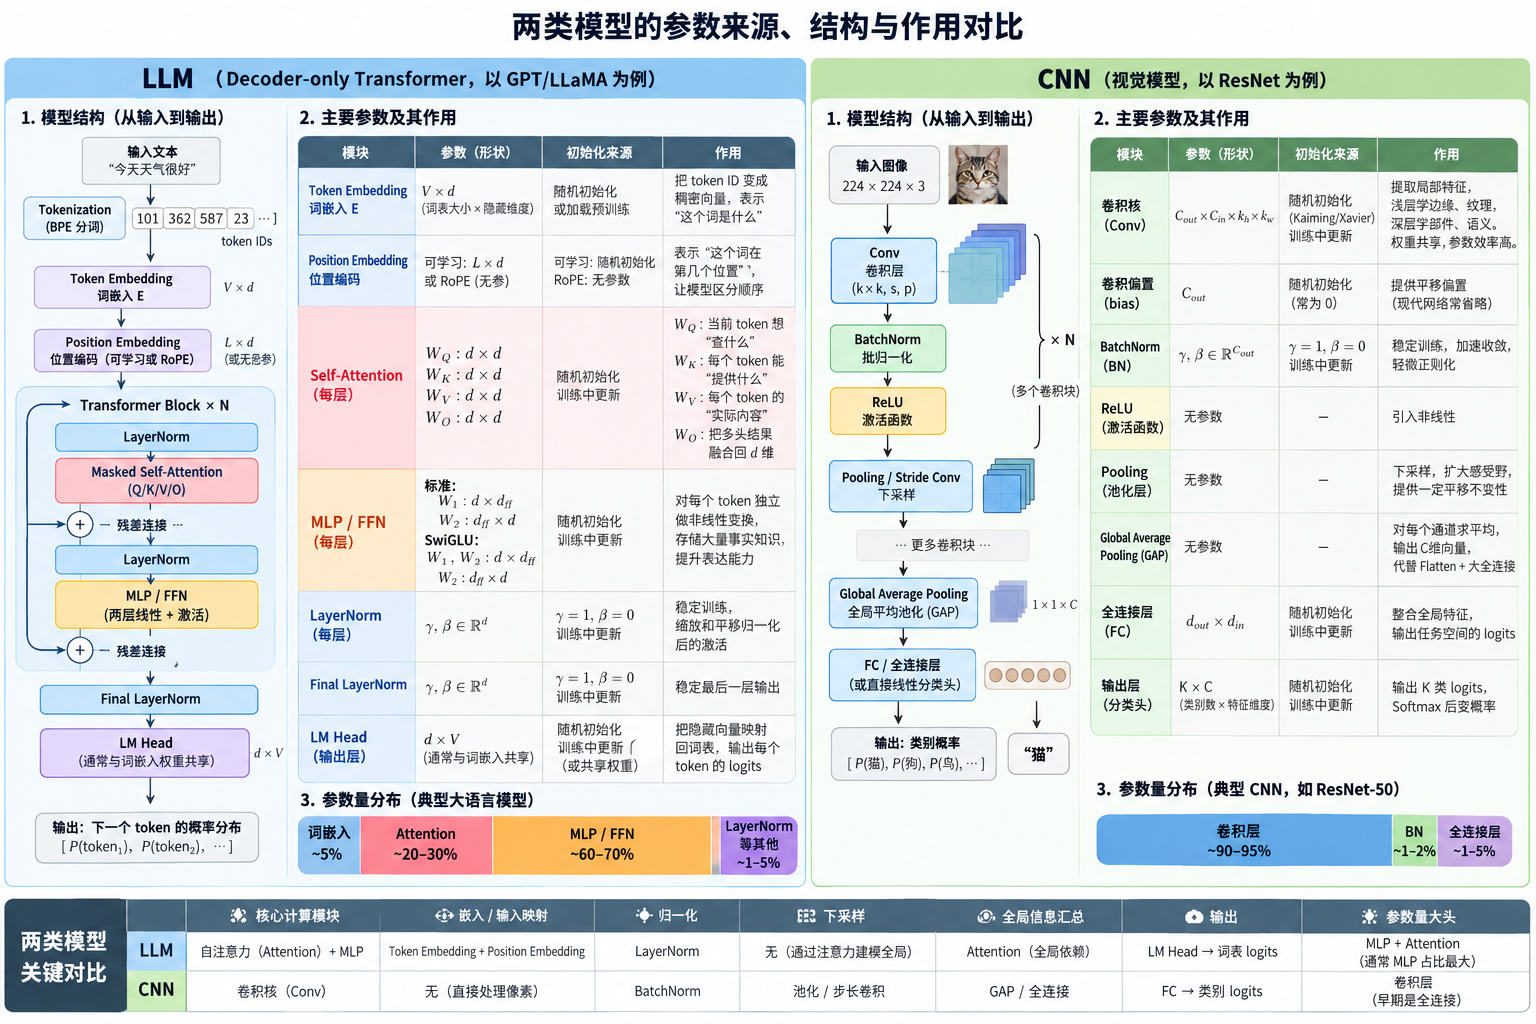
进一步阅读:Deep learning:表示学习与训练 · GPT-3:在上下文中提供示例
03 / 横向历史
横向看技术演化,点击节点向下读解释:它解决了什么问题,又有哪些能力边界。
不同任务,各有积累
这些路线在 2017 年后
仍然继续发展。
通用能力逐步积累
架构、训练方法与规模
共同推动后续发展。
图文对应 · 看图对话 · 机器人动作
图像生成 · 视频生成 · 世界模型
分步推理 · 工具调用 · 经验与学习
连接表示学习顺序,各路线会交叉,并非严格的模型继承关系。
虚线节点:拓展问题,另有历史来源2017 · 关键架构节点
用注意力机制,让序列中的不同位置交换信息。
处理一句话时,模型可以根据当前内容,对不同位置的信息赋予不同权重。Transformer 最初用于机器翻译,后来逐步进入语言、视觉和生成等领域。
用一个例子理解
读到“我把苹果放进袋子,因为它很大”时,理解“它”需要结合其他词的信息。注意力提供了建立这种关联的一种计算方式。
注意力是计算机制;模型能建立词语关联,并不保证每次都理解正确。
横向地图给出主要节点,下面保留原始学习图,并补充需要修正的历史表述。
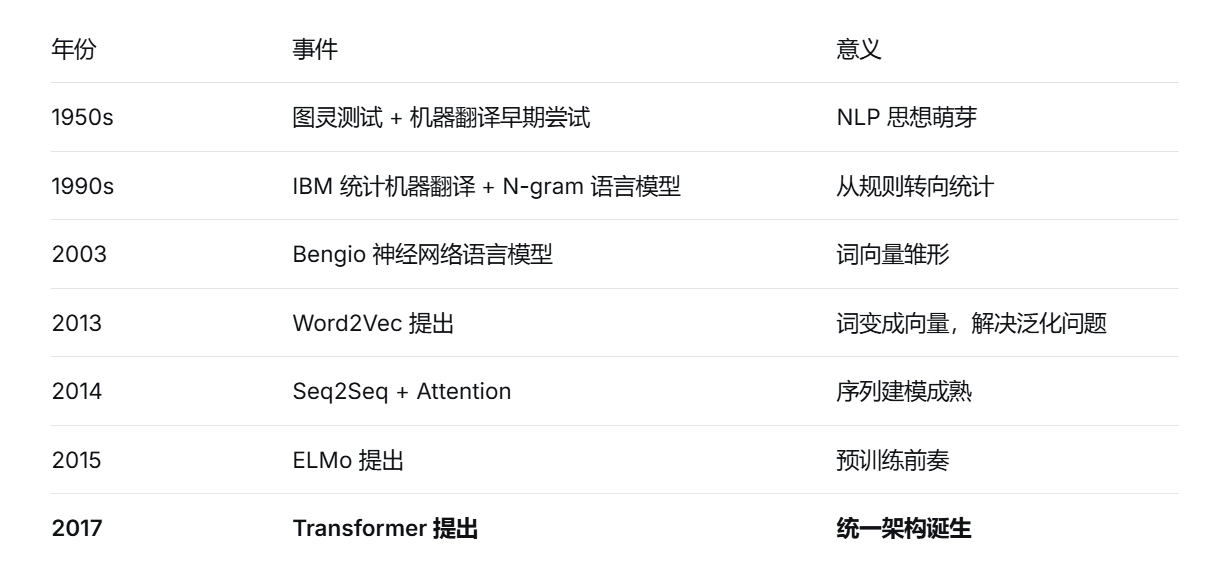
读图提示:2017 年 Transformer 是重要时间标记,各条路线仍按自己的节奏发展。感知与决策在 DQN 等早期系统中就有结合。早期 Stable Diffusion 使用 U-Net;不能将其视为 Transformer 统一架构下的直接后代。
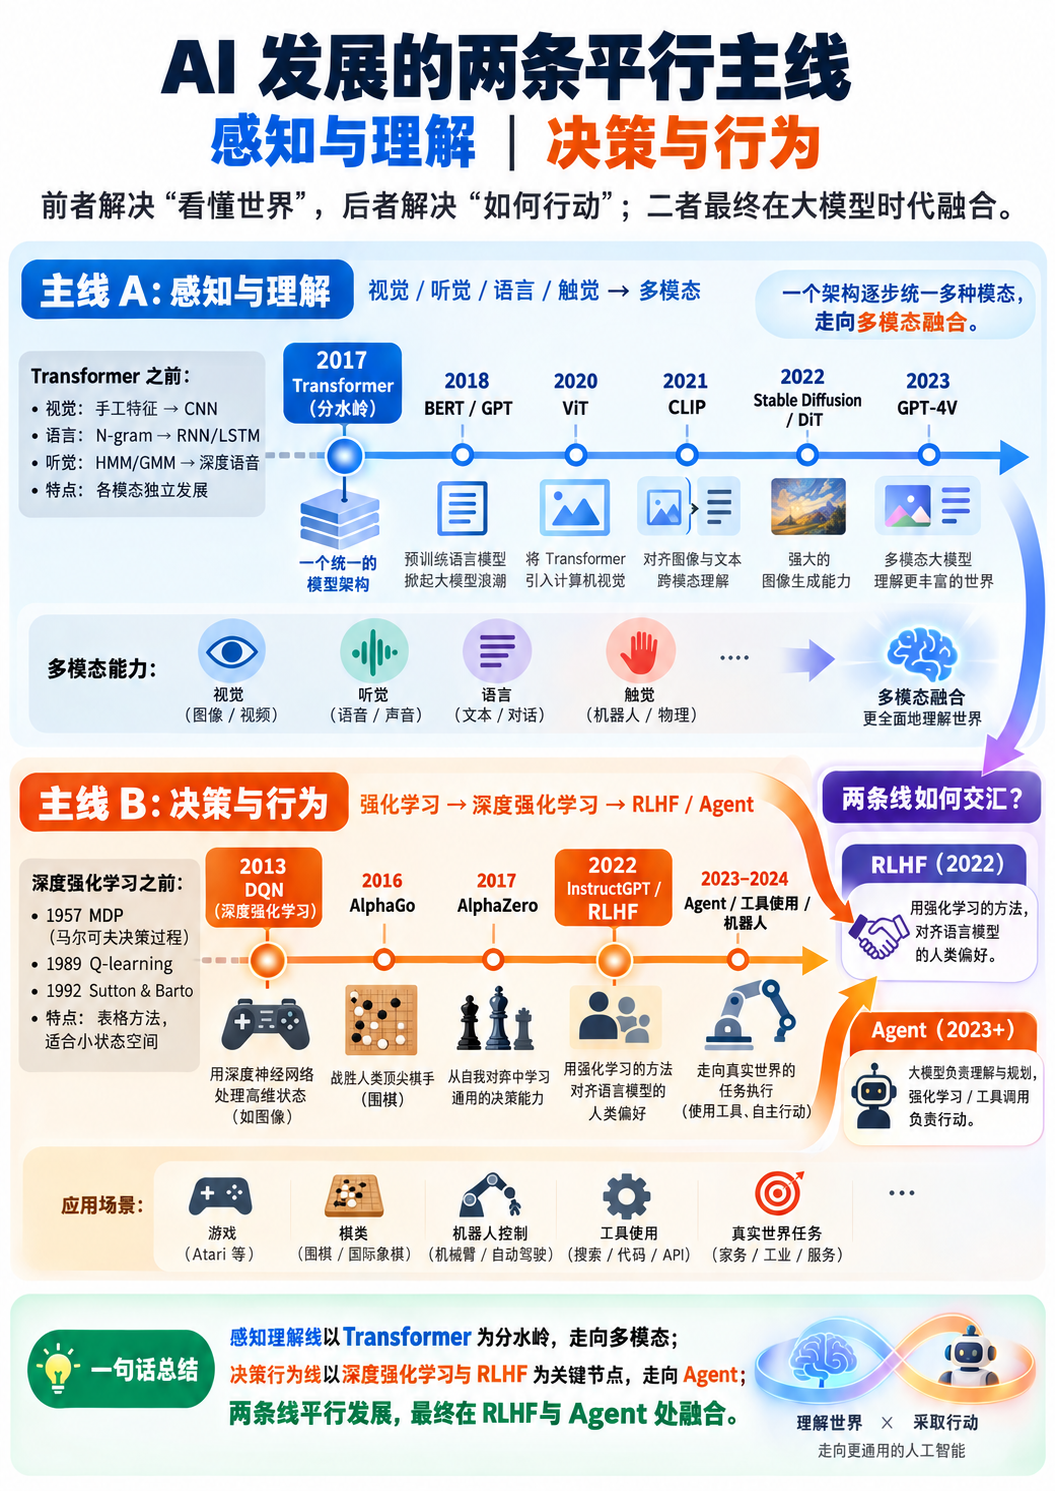
读图提示:1980 年应排在 1986 年之前。1986 年是反向传播推广的重要节点,并不是多层感知机的诞生年份;“1998 年 CNN 全面超越 MLP”也过于绝对,不同任务的适用性需要分别讨论。
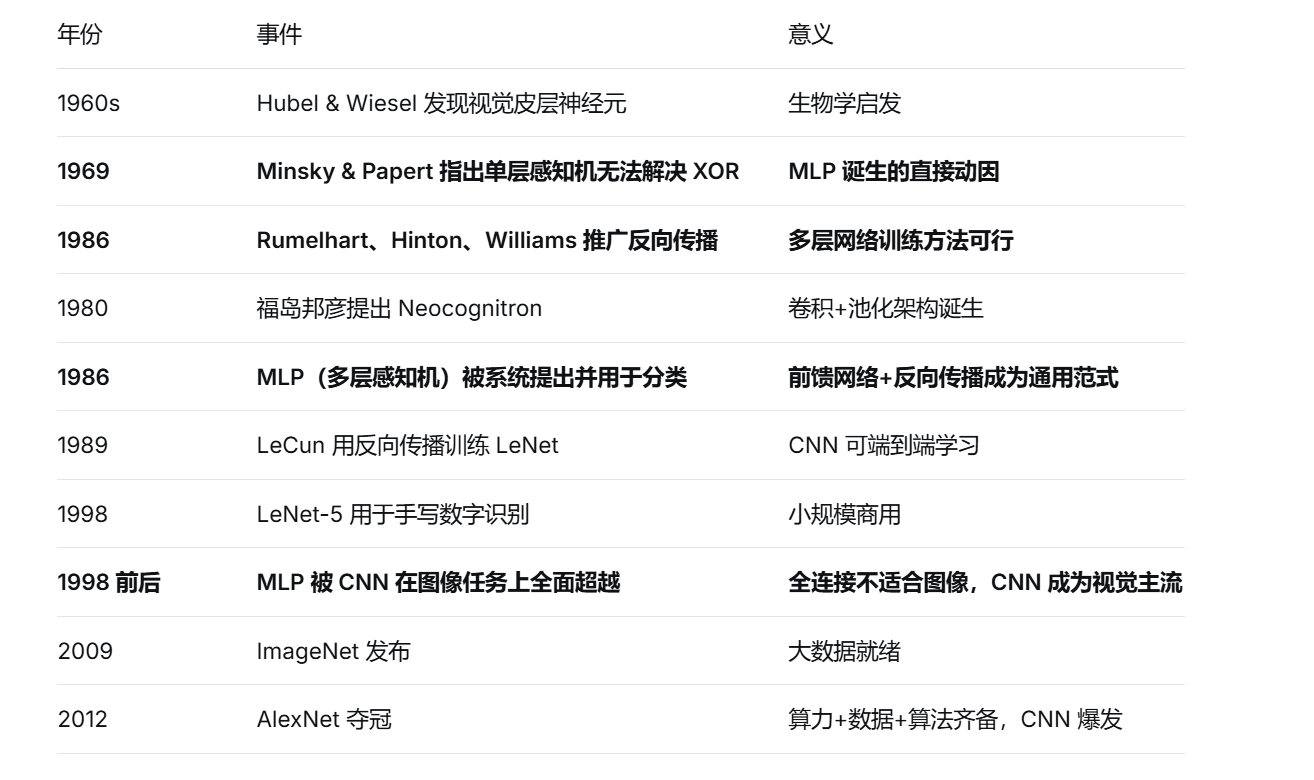
读图提示:ELMo 通常以 2018 年论文为节点,图中的 2015 年需要修正。Transformer 在 2017 年提出,之后逐步进入更多领域,并非当年就统一了所有模型。