一 从预测文字到生成图像
为什么transformer能输出视觉token 他训练的任务不是下一个字吗X1-M201 · 2026-10-12 · 原对话 ↗
这句话保留的思路
我已经用“预测下一个文字”理解语言模型,所以遇到图像输出时,会追问原来的训练任务怎样支持这个新能力。
本次整理
这里需要拆开网络结构与训练任务。Transformer 提供处理表示的计算结构;训练数据、输出接口和损失决定模型被训练去完成什么任务。
Transfusion 提供一个公开样本:文字采用下一 token 预测,图像保持连续潜表示并采用扩散目标,共用 Transformer 主干。文本位置计算交叉熵,图像位置计算扩散损失,加权形成训练目标。图像并不因此变成文字词表中的下一个编号。[R20] ↗
二 到底是谁在一步步生成图像
继续讲transformer到diffusion生图的部分 transformer输出了什么给diffusionX1-M199 · 2026-10-12 · 原对话 ↗
原 AI 解释中的问题
X1-M200、M204 把“Transformer 输出条件,再交给扩散模型”作为主要解释,又混入共享主干的表述。这会让人把 Transformer 和 diffusion 想成固定前后相接的两个模型。
本次核对
Transfusion 中,共享 Transformer 也参与图像去噪预测。生成图像时,将带噪图像表示与文本上下文一起输入模型,反复预测并由采样算法更新图像状态,最后经图像解码得到像素。文本使用因果注意力,同一图像的 patch 之间允许双向注意力。[R20] ↗
我想记住的区别可以概括为:Transformer 说明主要计算结构,扩散说明这里采用的生成建模方式;两者可以在同一个系统内配合。(整理者拟写,待本人确认。)
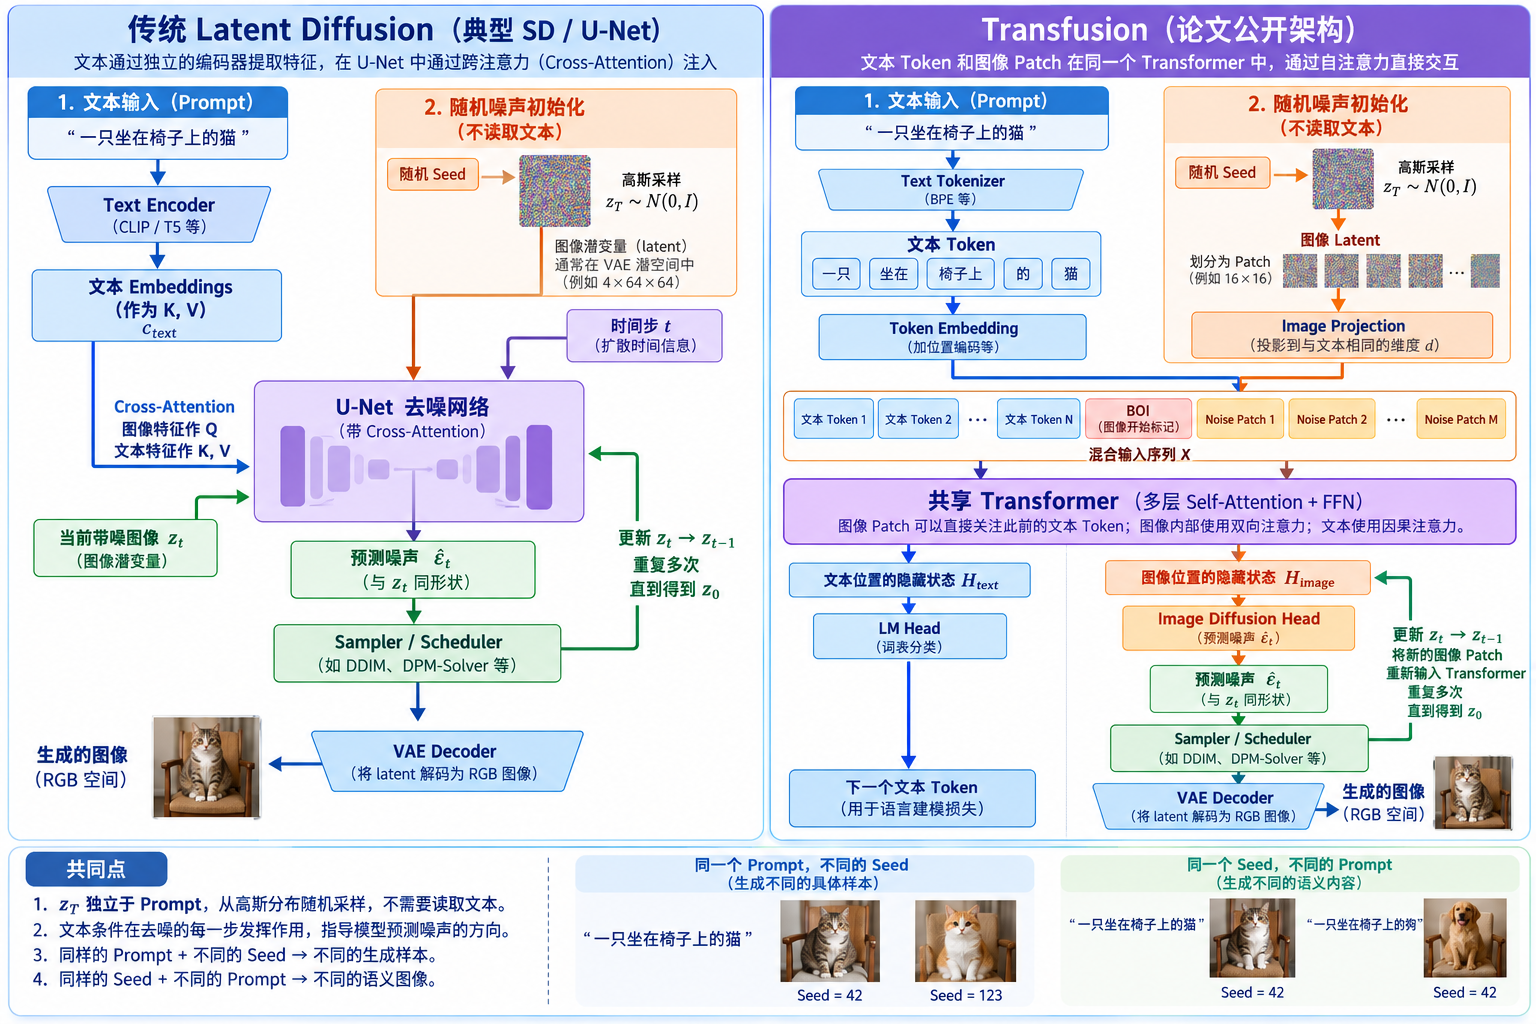
读图校注 1
右侧采样器更新后的图像潜变量,应重新经过图像输入映射进入共享 Transformer。图中绿色回路画到了隐藏状态旁,阅读时应按完整输入回路理解。
读图校注 2
Transfusion 需要扩散时间步信息,右图省略了这项输入;不能理解成只给文本和噪声、不告诉当前噪声水平。
读图校注 3
图主要对照生成时的信息流。右下“用于语言建模损失”涉及训练:训练时文本位置与图像位置分别计算对应损失;通常推理时使用已训练权重,不因此计算训练损失并更新权重。
读图校注 4
左侧是以 U-Net 为主干的典型潜扩散示意;原版常见 Stable Diffusion 使用 CLIP 文本编码器。图中的“CLIP / T5 等”和 patch/latent 尺寸属于跨实现举例,不能全部当成某一具体模型或 Transfusion 论文的固定配置。
三 放在同一个序列里 就能理解彼此吗
问题就是 如果两个模态都token化 是什么能让他们两个语义上也互通 自注意力就可以吗X1-M189 · 2026-10-12 · 原对话 ↗
这条消息前半段贴入了一段关于 GPT-4o 的架构解释;这里只选取用户自己追加的问题。
那反向传播的时候 哪个怎么知道应该是调整自己呢 这个训练过程 官方没有说明是吧X1-M195 · 2026-10-12 · 原对话 ↗
本次整理
第一问追的是“信息能交换,是否就等于语义对上了”;第二问追的是“误差怎样分配给参与计算的模块”。
注意力提供交互通道,训练中的配对关系和目标才使这种交互有机会变得有用。反向传播通过计算图与链式法则求每个可训练参数的梯度,优化器据此更新。模块不需要先知道自己“应当负责哪一种错误”。冻结范围、损失位置与计算图共同决定哪些参数实际受到影响。[R22] ↗
这一段值得与 B 放在一起:B 追输入输出,C 追训练信号如何沿这些计算关系起作用。
四 同样的 Prompt 为什么得到不同图片
你不是说生成满噪声图的时候不看 文本吗 这个是啥意思 那不就是单纯随机种子不一样 最开始的满噪不一样吗 也就是每次虽然一样的Prompt 一样的权重 但是生成的图会有点区别的原因吗GPT4o架构训练方式 · D · 2026-10-16 · 原对话 ↗
这句话保留的思路
我在区分“初始噪声怎么来”和“文本从哪一步开始起作用”,并尝试用这个区别解释同一个提示词生成不同结果。
本次整理
在这里讨论的常见扩散生成设置中,初始噪声从预设分布采样,不需要先读懂 Prompt。去噪网络处理带噪状态时,再利用文本条件。改变 seed 会改变随机数序列,通常也改变初始噪声;随机采样器还可能在后续步骤引入随机性。[R23] ↗、[R24] ↗
便于回忆的分工是:Prompt 给出条件,模型权重保存训练所得的规律,噪声提供一次采样的随机起点,采样算法决定状态如何迭代更新。
固定 seed 也不保证换设备、软件版本后逐位一致。讨论复现时,还要记录模型版本、采样器、步数等条件。[R25] ↗
五 从一个起点到许多终点
我明白了 但是这个从满噪声的图或者说这个潜空间的随机张量 通过Prompt就能到想要的图 我们世界上的图像元素感觉比文字多吧 有从一个出发点能到无数个终点的感觉 图像元素和文字元素哪个多 或者说我们衡量图像和文字的最小单位是什么 像素和token吗GPT4o架构训练方式 · E · 2026-10-17 · 原对话 ↗
本次整理
这时问题已经从模块连接走到“生成空间有多大”。“许多终点”保留了对生成多样性的直觉;但若完整初始状态、条件和确定性计算过程全部固定,同一次运行不会自行选择任意终点。多样性来自改变条件、初始噪声或后续随机采样等因素。
像素是图像的一种表示单位,文本 token 依赖分词器。图像进入模型时还可能被表示为 patch 或潜变量;潜空间压缩保留的是重建所需的信息,也包括纹理和细节,不能直接称为“纯语义”。[R21] ↗
保留的问题
比较图像和文字,究竟是在比较表示长度、可能组合数、信息量,还是处理它们的计算成本?明确比较对象后,才能回答“哪个更多”。
六 我开始把结构与语义对齐连起来
这个架构还完美完成了高维语义对齐的问题 这样在扩散模型学到的图像知识就能和Prompt的语言知识 在语义上对齐 也就指导了图像要符合的语义方向了GPT4o架构训练方式 · F · 2026-10-17 · 原对话 ↗
这句话值得保留的原因
它把前面分散的“文本条件、图像生成、共享计算、训练目标”联系起来,表达了当时对文字能够指导图像的理解。
本次修正
“完美完成”超出了证据。这样的结构与训练可以支持文字条件指导图像生成,具体能否画对对象、数量和关系仍要评价。共享主干也不意味着每个模态都拥有完全相同、可逐维对应的语义表示。
这篇笔记的收束
这组问题连接了三个层次:结构怎样处理不同输入,训练目标怎样塑造能力,生成时怎样把条件与随机性结合起来。Transfusion 是研究这些问题的公开例子;本稿不据此推定 GPT-4o 的具体内部实现。
仍待继续的问题
两种损失怎样配平,图文训练会怎样互相影响;怎样测量“语义对齐”;训练随机性与生成随机性分别怎样记录。
核对来源 · 6 项
- [R20] Transfusion 第 3 节 ↗
- [R21] LDM ↗
- [R22] PyTorch 自动求导 ↗
- [R23] DDPM ↗
- [R24] Diffusers 可复现生成 ↗
- [R25] PyTorch 可复现性 ↗
技术核对:2026-10-17。个人学习记录只代表原对话当时的范围。