把预测触觉接到新任务,怎样判断它真的有用?
源域为 ManiFeel 单臂 USB 插入,目标域为 AV ALOHA 双臂插入。目标侧只有 RGB、可部署状态和动作示范,训练及部署均不使用目标真实触觉。
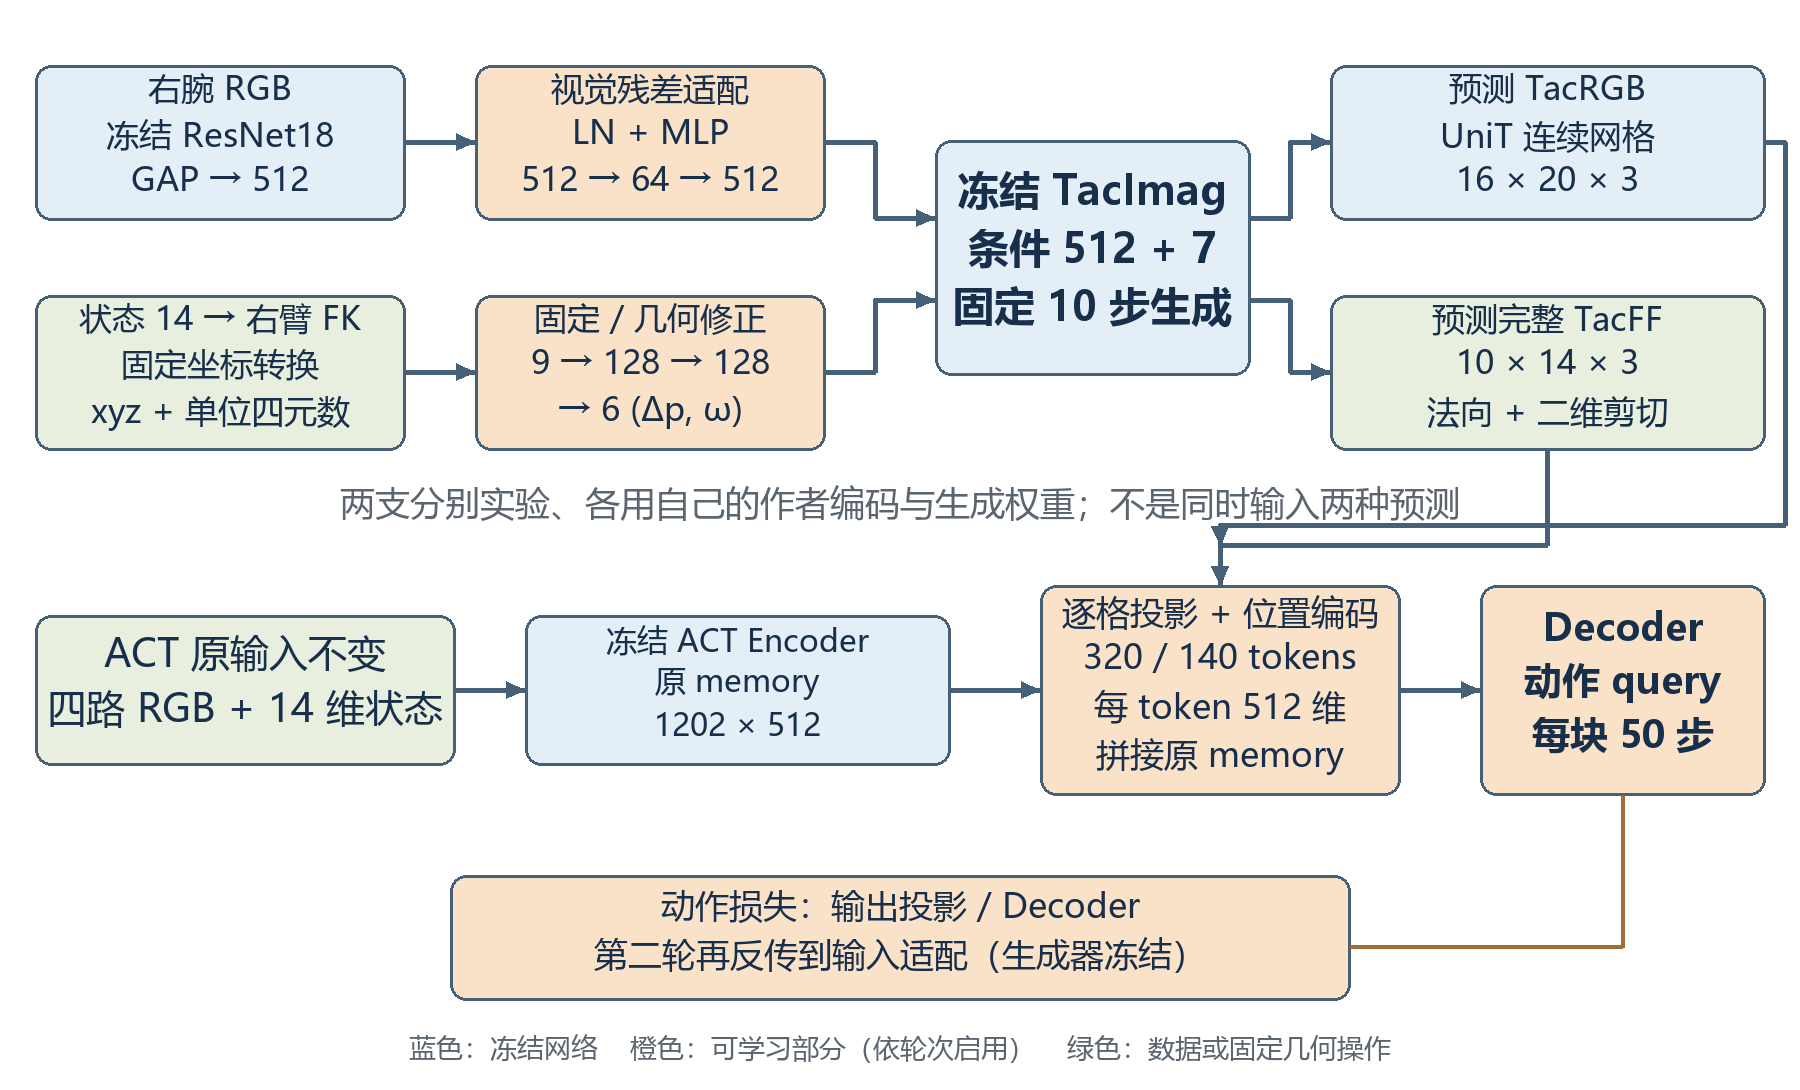
先把接口接清楚
左右滑动查看完整表格
| 环节 | 做法 | 要保留什么 |
|---|---|---|
| 视觉与状态 | 右腕 RGB;右臂正向运动学与固定坐标变换得到 xyz + 单位四元数 | 保留位置、姿态的物理含义 |
| 触觉生成 | 冻结 TacImag 的生成权重,按各自公开配置进行 10 步采样 | 观察跨域生成能提供什么内容 |
| TacRGB 接口 | UniT 量化前 16×20×3 连续网格 → 320 个 512 维 token | 空间结构;不是离散码本编号 |
| TacFF 接口 | 完整 10×14×3 网格 → 140 个 512 维 token | 法向、两维有符号剪切与位置 |
| ACT 读取 | 新增 tokens 接在原 Encoder memory 后,通过 Decoder 交叉注意力读取 | 原四路图像与 14 维状态保留;每块 50 步动作 |
训练时哪些部分会变?
第一轮固定生成器、输入转换与 UniT,只训练输出投影、模态向量、Decoder 和动作 query;损失为示范动作 L1,加 0.1 倍相对固定 ACT 的行为 MSE 约束。
第二轮只增加视觉适配,或同时增加视觉与几何状态适配。动作损失可以穿过冻结生成器的采样链更新输入适配器;生成器的权重本身不变。
两轮均使用 40 条目标训练演示、10 条开发演示和 ACT 种子 144/145/146。每模型 12 轮、6060 次更新;第 1/6/12 轮用 50 个共享初态选模,随后在另外 200 个共享初态测试。
第一轮:接入后的收益来自什么?
左右滑动查看完整表格
| 方法 | 种子144 | 145 | 146 | 均值 |
|---|---|---|---|---|
| D · 纯 Decoder | 50.5% | 52.5% | 52.5% | 51.83% |
| R · 预测 TacRGB | 54.5% | 56.0% | 52.0% | 54.17% |
| F · 预测 TacFF | 54.0% | 56.5% | 55.5% | 55.33% |
E75-1 · 2026-11-07 · 每模型 200 回合;三个训练种子共享 200 个环境初态,不是 600 个独立初态。汇报表 4 与独立成功计数报告一致。
TacFF 比纯 Decoder 平均高 3.50 个百分点,三个种子方向一致。但增加支路也改变了训练,仍需检查策略是否用到了与当前状态对应的触觉内容。
E75-M · 2026-11-07 · 原测试集上的事后内容干预,正常轨迹复用;不是一批新的独立复验。
第二轮:让动作监督修正输入条件
左右滑动查看完整表格
| 输入适配 | TacRGB 均值 | TacFF 均值 |
|---|---|---|
| 固定输入 | 47.67% | 48.17% |
| 只学视觉 | 49.67% | 47.17% |
| 视觉 + 状态 | 49.33% | 47.67% |
E75-2 · 2026-11-08 · 新一批 200 共享初态,三种子均值;同批纯 Decoder 为 46.67%。与第一轮的绝对成功率不直接排序。
适配器确实改变了输入,TacFF 预测也有明显响应,但没有形成稳定的附加成功率收益。目标没有真实触觉标签,预测发生变化并不能证明受力更准确。接下来需要分清:生成内容是否对应当前接触,以及同一策略是否会因这些内容而改变动作。
参考来源
- [1]TacImag · 由视觉与状态生成触觉
本研究复用的公开生成器来源
- [2]ManiFeel · 仿真触觉与操作基准
源域任务、模态与评价背景
讨论与留言
这里的留言公开可见。欢迎分享你的理解,也可以指出值得修正的地方。
这项研究的留言
正在读取留言…